De Analytics Engineer: de schakel tussen data en business
Daniël van Meurs werkt als Analytics Engineer bij Creates, een relatief nieuwe functie die je steeds vaker tegenkomt in datateams. Maar wat doet een Analytics Engineer eigenlijk, en wat onderscheidt de rol van de Data Engineer en de Data Analist die we al veel langer kennen? Daniël legt uit hoe de functie is ontstaan, waar die zich tussen techniek en business bevindt en waarom het datamodel het hart van zijn werk is.
Twee rollen, één overdracht
Lange tijd was er binnen datateams een heldere taakverdeling. De Data Engineer ontsloot de data uit de bronsystemen, transformeerde die en zorgde dat alles in het warehouse terechtkwam. De Data Analist nam het vanaf daar over: het semantische datamodel samenstellen, dashboards bouwen en het contact met de businessgebruikers onderhouden.
Die opzet heeft een duidelijk voordeel: beide rollen kunnen zich specialiseren in hun eigen vak. Maar de scheiding kent ook beperkingen. De engineer heeft een blinde vlek voor de businesslogica, terwijl de analist geen zicht heeft op hoe de ruwe data is getransformeerd. Alles hangt af van de communicatie daartussen. Gaat daar iets mis, dan interpreteert de engineer de businesslogica verkeerd of verliest de analist het vertrouwen in de juistheid van de data.
De Analytics Engineer bestrijkt een groot deel van beide vakgebieden (Afbeelding 1). Daarmee verdwijnt de overdracht niet, maar verschuift hij naar een plek waar hij veel minder risico met zich meebrengt. Waarom dat zo is, wordt duidelijk als we kijken naar hoe data van bron naar dashboard stroomt.
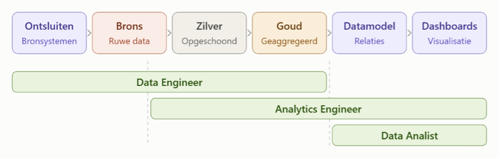
Afbeelding 1: Waar de Data Engineer, Analytics Engineer en Data Analist doorgaans actief zijn op de route van bron naar dashboard. De Analytics Engineer begint meestal bij de ruwe data in de bronslaag en overlapt daarmee met beide andere rollen. De stippellijnen markeren de gebruikelijke overdrachtsmomenten; in de praktijk zijn die grenzen niet hard.
Van ETL naar ELT
Klassiek gezien was ETL, of Extract, Transform, Load, de standaardmanier om data uit bronsystemen in het warehouse te krijgen. De data wordt eerst ontsloten, daarna buiten het warehouse getransformeerd en pas daarna ingeladen. Tussenstappen zoals opschonen en samenvoegen gebeuren in die opzet in de ETL-tooling zelf. Wat in het warehouse landt, is direct de schone, geaggregeerde data die in een medaillonarchitectuur de goudlaag zou vormen. Het hele ETL-traject lag bij de Data Engineer, waarna de Data Analist met die data het semantische model samenstelde.
Die volgorde had een goede reden: opslag en rekenkracht in een warehouse waren duur, dus je laadde alleen in wat je echt nodig had. Met de komst van cloudwarehouses is dat veranderd. Opslag is goedkoop geworden en rekenkracht schaalt mee met de vraag. Daardoor werd het aantrekkelijk om de volgorde om te draaien: ELT, of Extract, Load, Transform. De data wordt ontsloten, eerst ruw ingeladen en pas daarna binnen het platform zelf getransformeerd. Die ruwe data vormt de bronslaag, en de zilver- en goudlaag worden daaruit opgebouwd. Uit dezelfde ontwikkeling ontstond ook het lakehouse: een architectuur die de goedkope, flexibele opslag van een data lake combineert met de structuur en betrouwbaarheid van een warehouse. De opbouw van brons naar goud, de medaillonarchitectuur, is daarin de standaard geworden.
Juist die verschuiving maakte de rol van Analytics Engineer mogelijk. De Data Engineer voert de E en de L uit en zorgt dat de ruwe data betrouwbaar in de bronslaag terechtkomt. Vanaf daar neemt de Analytics Engineer het stokje over. De transformaties vinden nu plaats in het lakehouse zelf, bij Creates in Microsoft Fabric of Databricks. Daardoor kan de Analytics Engineer ze zelf in SQL of PySpark schrijven. Met tools als dbt, dat met beide platformen samenwerkt, kun je die transformaties bovendien als code beheren, testen en documenteren. Daar komt ook het 'engineering' in de functienaam vandaan: werkwijzen uit de softwareontwikkeling, zoals versiebeheer, geautomatiseerde tests en code review, toegepast op het transformeren en modelleren van data.
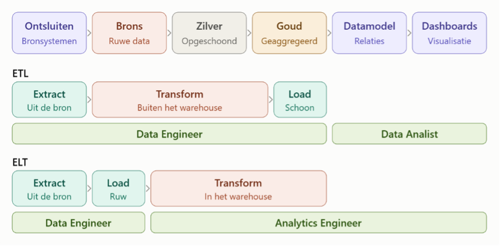
Afbeelding 2: ETL en ELT naast elkaar. Bij ETL wordt de data getransformeerd voordat hij het warehouse bereikt en ligt het hele traject bij de Data Engineer. Bij ELT wordt de ruwe data eerst in de bronslaag van het lakehouse geladen en voert de Analytics Engineer de transformatie daar uit.
Waar techniek en business samenkomen
Tot nu toe ging het vooral over wie wat doet: welke stappen bij de Data Engineer liggen, waar de Analytics Engineer het stokje overneemt en waar de Data Analist begint. Dat is het zichtbare deel van de verschuiving. Maar de echte verandering zit niet in het verplaatsen van taken van de ene rol naar de andere. Die zit in wat er gebeurt als degene die met de business praat, ook degene is die de transformaties schrijft.
In de klassieke opzet ging een vraag uit de business via de Data Analist naar de Data Engineer, en kwam het antwoord als tabel weer terug. Elke schakel in die keten is een moment waarop betekenis verloren kan gaan. Hoe makkelijk dat gebeurt, merkte ik zelf bij een klant.
Daar moest in het model een 'Brutosaldo' komen. Bruto klinkt als iets vóór belasting, en saldo wordt vaak gebruikt als een ander woord voor bedrag. Geen van beide bleek te kloppen: bruto stond in de definitie van de klant voor de verkoopwaarde van de voorraad, en saldo was het bedrag na verrekening van de retouren. Dat ontdekte ik pas toen ik er met mensen van de klant over doorpraatte. Het brutosaldo staat niet kant-en-klaar in de brondata, maar moet in de transformaties worden samengesteld. Dan moet je precies weten wat het is.
In een klassieke opzet had de Data Analist die definitie moeten doorgeven aan de Data Engineer, die de berekening vervolgens bouwt. Elke extra stap vergroot de kans dat zo'n nuance onderweg verloren gaat. Als de Analytics Engineer die vragen zelf stelt en het antwoord direct in code vastlegt, blijft de betekenis intact van het eerste gesprek tot het uiteindelijke model. De overdracht die overblijft, tussen Data Engineer en Analytics Engineer, gaat alleen nog over de ruwe brondata, niet meer over wat de business ermee wil weten.
Daarmee is ons werk maar voor de helft technisch. De andere helft bestaat uit luisteren, doorvragen en keuzes maken die niet in de data zelf staan. Nergens komen die twee helften zo duidelijk samen als in het datamodel.
Geen twee dezelfde motoren
Een datamodel is geen logisch gevolg van één of meer ruwe datasets, maar de uitkomst van een proces waarin continu keuzes gemaakt moeten worden. Geef twee autofabrikanten de opdracht om uit dezelfde ruwe materialen een motor te bouwen, en het is onwaarschijnlijk dat er twee identieke motoren uitkomen. Zo is ook de kans klein dat twee Analytics Engineers vanuit dezelfde ruwe data, met een bonte verzameling stakeholders en wensen, tot exact hetzelfde datamodel komen. Wat er in het model terechtkomt, is het resultaat van een afweging tussen wat de brondata toelaat, hoe de businesslogica geïnterpreteerd moet worden, wat de dashboardgebruiker nodig heeft en wat een computer efficiënt kan verwerken.
Die keuzes hebben gevolgen. Het model vormt de 'waarheid' waarop dashboards en bedrijfsvoering rusten: op basis hiervan worden besluiten genomen en strategieën gebouwd. Daarmee is het datamodel het hart van ons werk.
Wat mensen doen, bijvoorbeeld een aankoop in een winkel, wordt vastgelegd als ruwe data. Ook dat is al een vertaling: iemand, vaak een ontwikkelaar bij de leverancier, heeft bepaald hoe een kassasysteem een aankoop, een korting of een retour registreert. Om die data goed te ontsluiten, moet de Data Engineer begrijpen wat er in de bron staat en waarom. Wij vertalen die ruwe data vervolgens naar een model waarmee de computer razendsnel uit de voeten kan, met als doel de uitkomst weer op een behapbare manier aan mensen te tonen. Via BI-tooling gaat het resultaat terug naar dezelfde business waar de data vandaan kwam, en ontstaan er nieuwe vragen. Dat is een cirkel die continu doorgaat, en de Analytics Engineer staat in het midden om hem rond te maken (Afbeelding 3).
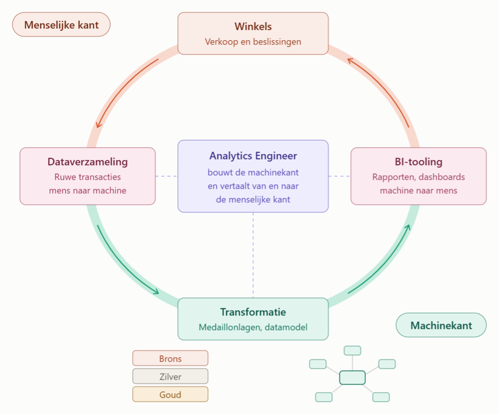
Afbeelding 3: De cyclus van datagedreven besluitvorming, met winkels als voorbeeld. Wat er in de winkel gebeurt, wordt door de kassasystemen vastgelegd als ruwe transacties en door de Data Engineer ontsloten. In de transformatiestap wordt die data via de brons-, zilver- en goudlaag omgezet naar een stermodel met een feitentabel en vijf dimensies. Via BI-tooling komt het resultaat als rapport of dashboard terug bij de mensen die de beslissingen nemen. De Analytics Engineer bouwt de machinekant en vertaalt van en naar de menselijke kant.
Tot slot
Analytics Engineering is ontstaan uit een technische verschuiving, maar de waarde zit in wat die verschuiving mogelijk maakte. Doordat transformaties in het lakehouse plaatsvinden en als code beheerd kunnen worden, kan één persoon het hele traject overzien: van het eerste gesprek met de business tot het model waarop die business haar beslissingen baseert. Dat vraagt om iemand die zich in beide werelden thuis voelt. Iemand die een stermodel kan ontwerpen, maar ook kan doorvragen tot helder is wat 'Brutosaldo' nu eigenlijk is.
Het is precies die combinatie die ervoor zorgt dat een dashboard niet alleen klopt, maar ook antwoord geeft op de vraag die er echt gesteld werd.
In mijn volgende blog ga ik dieper in op het datamodel zelf: hoe het werkt en hoe het zorgt voor snelle Power BI-rapportages.