Snel én veel: waarom een dashboard een goed datamodel nodig heeft
Gebruikers van dashboards willen twee dingen die op het eerste gezicht niet samengaan: antwoord binnen een seconde, en het liefst over meerdere jaren historie. Daniël van Meurs, Analytics Engineer bij Creates, weet waar dat gevecht wordt beslecht: niet in het dashboard zelf, maar in het datamodel eronder. In zijn vorige blog beschreef hij wat een Analytics Engineer doet. Nu duikt hij in het hart van dat werk: hoe een computer met data omgaat, en wat een datamodel daarom nodig heeft om snel te kunnen rekenen.
Snel én veel data
Als Analytics Engineer begint het technische aspect van mijn werk bij de ruwe data in de bronslaag en eindigt het bij de dashboards die ik oplever. Deze dashboards moeten niet alleen de juiste informatie en diepgang hebben maar ze moeten ook snel zijn. Een wachttijd van één seconde wordt vaak als richtlijn gehanteerd. De snelheid van een dashboard wordt bepaald door hoe snel het data kan verwerken én door hoeveel data het moet verwerken. Naast snelheid verlangen gebruikers vaak dat er zo veel mogelijk data (bijvoorbeeld meerdere jaren terug) geanalyseerd kan worden. Als je deze vraag naar snelheid én volume in een auto-analogie wilt vatten kun je zeggen dat de gebruiker het liefst een volle parkeerplaats met Formule 1-auto’s heeft (Afbeelding 1).
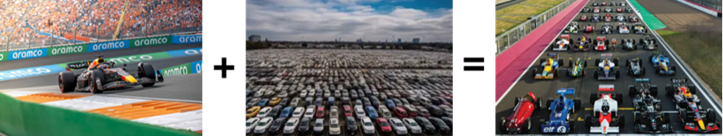
Als we de vergelijking met een auto nog even doortrekken dan is het dashboard de auto die je ziet: snel en flitsend. Net zoals ruwe data de bron is waaruit het dashboard wordt gevormd, zo is een auto ook samengesteld uit ruwe materialen en onderdelen. Maar wat de prestaties van de auto echt bepaalt, is de motor. Of voor een dashboard: het datamodel.
Het datamodel
Als we het over het datamodel hebben dan bedoelen we het semantisch model dat is samengesteld uit tabellen uit de gouden laag. In het model slaan we data op een efficiënte manier op en definiëren we relaties tussen tabellen zodat het dashboard zo effectief mogelijk met de data om kan gaan. De reden dat een dashboard een solide datamodel nodig heeft zit hem in het dynamische karakter van het dashboard én in het ongeduld van de gebruiker.
Het mooie aan een dashboard is dat de gebruiker enorm veel vrijheid heeft. Filters bieden de mogelijkheid om alle gewenste combinaties te maken (deze winkel, dit product, deze klant, dit kwartaal, etc.). Die vrijheid heeft een prijs: elke aanpassing die een gebruiker maakt in de filterselectie resulteert in een nieuw verzoek waarbij de data binnen één seconde getoond moet worden en ook vaak opnieuw uitgerekend moet worden.
Het datamodel zet de data dus zo klaar dat het dashboard, of beter gezegd de computer, er zo snel mogelijk mee kan rekenen. Hoe snel een dashboard bijvoorbeeld je KPI's kan tonen, staat of valt daarmee. Maar wat maakt een datamodel dan anders dan de ruwe data waaruit het is opgebouwd? Om die vraag te beantwoorden, kijken we eerst naar hoe een computer met data omgaat.
Hoe een computer met data omgaat
Wat voor een computer efficiënt is, hangt af van de taak: data opslaan vraagt iets heel anders dan data analyseren. Maar laten we bij het begin beginnen: hoe slaat een computer een tabel op? In tegenstelling tot wat sommige films je willen doen geloven, niet in een tweedimensionale Matrix. Een tabel bestaat voor een computer uit een serie eendimensionale cijferreeksen. Daarvoor zijn twee mogelijkheden: een cijferreeks per rij, of een cijferreeks per kolom. Wij mensen werken graag met rijen, elke rij is een observatie (een winkelaankoop) waarbij elke kolom een variabele (wie, wat, waar, wanneer, hoeveel, etc.) vertegenwoordigt. Als wij informatie willen opslaan, zoals een aankoop in een winkel of een transactie in je bankapp, dan kan een computer dit erg goed: één observatie wordt in één cijferreeks opgeslagen met alle variabelen. Dat gaat heel snel, en zo is de data in de meeste bronsystemen opgeslagen, zoals het kassasysteem van een winkel.
Laat nou net het opslaan van data en het analyseren van data voor een computer een compleet andere tak van sport zijn. Zoals onze functienaam al verraadt, zijn wij vooral geïnteresseerd in het analyseren van data. In tegenstelling tot het verwerken van transacties, waarbij data wordt opgeslagen, gaat het bij het analyseren van data vaak om rekenen. En bij analyseren werkt een computer niet graag met rijen. Kolommen zijn dan veel handiger voor een computer. Eigenlijk is dat best logisch en ik zal het uitleggen met een analogie.
Analogie: het fysieke archief
Stel jij werkt samen met één collega in een fysiek archief waarbij data wordt opgeslagen in grote stellingkasten. Jij bent verantwoordelijk voor de analyse van bestaande data terwijl jouw collega verantwoordelijk is voor de opslag van nieuwe data in het archief. Net als een tabel kennen de kasten ook een tweedimensionale indeling. Kasten met horizontale planken kunnen we volzetten met brede dozen (per rij) en kasten met verticale schotten kunnen we vullen met lange dozen (per kolom). Ook hier bevat elke rij van de kast een observatie en elke kolom een variabele. Nu is de vraag: vullen we het archief met kasten met planken of kasten met schotten (Afbeelding 2)?
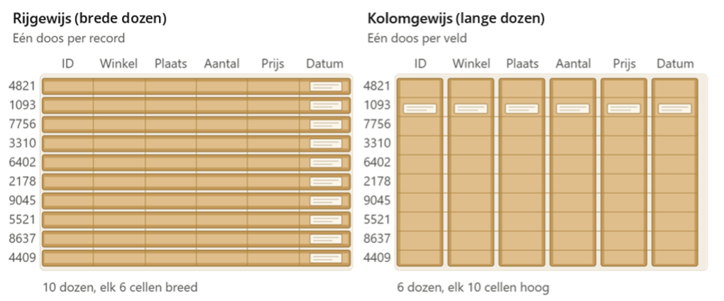
Jouw collega zal voor planken met brede dozen zijn. Elke nieuwe observatie die binnenkomt, kan in één nieuwe doos. IMet lange dozen zou jouw collega bij elke nieuwe observatie alle dozen moeten openen, om er telkens één variabele in te stoppen. Jij zult als analist van het archief echter een andere mening hebben. Jij zult vragen moeten beantwoorden als ‘wat is de gemiddelde prijs van alle observaties?’. Zit de data in lange dozen, dan open je alleen de doos met Prijs. Zit de data in brede dozen, dan moet je elke doos openen en daar de prijs uithalen om het gemiddelde te kunnen berekenen. In dit voorbeeld staan tien rijen maar in werkelijkheid kunnen datasets tientallen miljoenen rijen bevatten. Geen wonder dus dat computers voor analyse liever met kolommen werken.
Waarom kolommen sneller zijn
Het voordeel van kolommen gaat verder dan het archiefvoorbeeld laat zien. Twee dingen maken het verschil nog groter.
Ten eerste: in het archief ging het om een vraag over álle observaties, maar meestal wil je een deel van de data analyseren. Stel dat we de gemiddelde prijs willen weten van alle aankopen in augustus 2026. Met lange dozen weten we vooraf precies wat we nodig hebben: de doos met Prijs en de doos met Datum. Met brede dozen ligt dat lastiger. Je zou denken dat je alleen de dozen uit augustus hoeft te openen, maar de datum staat niet op de doos. Je moet dus alsnog elke doos openmaken om te zien of die observatie meedoet.
Natuurlijk kun je een register bijhouden van welke doos welke datum bevat; rijgebaseerde databases doen dat met een index. Zoek je één aankoop, dan is dat ideaal: opzoeken, naar de juiste plank lopen, klaar. Maar een maand omvat misschien honderdduizenden aankopen, verspreid door het hele archief. Dan loop je voor elke regel in het register kriskras door de gangen, en haal je uit elke doos de hele observatie tevoorschijn, terwijl je alleen prijs en datum nodig hebt. Op een gegeven moment is het sneller om gewoon alle planken langs te gaan, en databases kiezen bij grote vragen dan ook vaak zelf voor een volledige scan.
Met lange dozen speelt dit probleem niet. Je gaat met je vinger de doos met Datum af en noteert welke regels in augustus vallen. Daarna pak je dezelfde regels uit de doos met Prijs. Ook dat is een volledige scan, maar dan van één dunne doos in plaats van het hele archief. Het verschil zit hierin: welke kolommen je nodig hebt, staat in de vraag; welke rijen je nodig hebt, staat in de data.
Ten tweede bevat een kolom maar één soort gegevens, en daarin komen vaak dezelfde waarden terug. Denk aan een veelvoorkomende productprijs als € 1,95. In plaats van die prijs duizenden keren op te slaan, kan de computer een kort woordenboek aanleggen: € 1,95 krijgt bijvoorbeeld code 1, en in de kolom staat vervolgens alleen nog die code. Deze techniek heet dictionary encoding. De kolom wordt daardoor een stuk kleiner, zodat er minder data ingelezen hoeft te worden, en veel berekeningen kunnen direct op de korte codes worden uitgevoerd. In archieftermen: de lange doos met Prijs wordt een stuk dunner. Bij brede dozen werkt dit veel minder goed, omdat daarin allerlei verschillende soorten gegevens door elkaar zitten.
Deze manier van opslaan, columnar storage, zorgt niet alleen voor snelheid, maar maakt je dataplatform ook schaalbaarder en goedkoper. Minder data inlezen betekent minder rekenkracht, en bij BigQuery bijvoorbeeld letterlijk een lagere rekening, omdat je daar betaalt per hoeveelheid gelezen data. Niet voor niets maken databasesystemen als BigQuery, Snowflake en DuckDB gebruik van kolomopslag; ze staan bekend om hun snelheid bij analytische taken. Ook Microsoft Fabric, waar wij bij Creates veel mee werken, doet dat. Daar kom ik zo op terug.
Feiten en dimensies
Nu we begrijpen hoe een computer snel data kan verwerken, is het ook beter te begrijpen wat voor vorm het datamodel moet hebben. Zodra de data uit de bronsystemen in ons warehouse landt, wordt hij al kolomgewijs opgeslagen: Fabric bewaart tabellen in het Delta-formaat, dat gebaseerd is op de kolomopslag van Parquet. Het datamodel zet daar nog een stap bovenop. VertiPaq, de engine onder Power BI, houdt de kolommen gecomprimeerd in het geheugen, zodat er tijdens het rekenen niet meer van schijf gelezen hoeft te worden. Om daar optimaal gebruik van te maken, bouwen we een dimensioneel model volgens Kimball, in de vorm van een stermodel, met feiten en dimensies.
In de feitentabel staan in de basis twee soorten kolommen: de numerieke kolommen (de hoeveel?) waarmee de computer snel kan rekenen en de keys naar de dimensies. Je zou een feitentabel dus kunnen beschouwen als een set lange archiefdozen die klaarstaan om mee te rekenen. Het enige wat per berekening bepaald moet worden is welke waarden wel en welke waarden niet meedoen. Dat wordt bepaald via de dimensies.
Dimensies bevatten de categorische waarden zoals winkel, plaats en product, die antwoord geven op de eerder genoemde W-vragen (wie, wat, waar, wanneer). Een groot voordeel is dat ze de feitentabel sterk verkleinen. Niet zozeer omdat tekst duur is, want dictionary encoding maakt herhalende tekst al een stuk goedkoper, maar omdat één key een hele reeks beschrijvende kolommen vervangt: winkelnaam, plaats, regio, oppervlakte. Die staan één keer in de winkeldimensie, in plaats van als aparte kolommen naast tientallen miljoenen feitenregels. De feitentabel wordt daardoor vooral smaller.
Daarnaast vormen dimensies de ingang van het model. Een gebruiker die op 'Amsterdam' klikt, filtert in feite de winkeldimensie, waarin plaats een kenmerk van elke winkel is. Via de relatie plant dat filter zich voort naar de feitentabel. De filtering op de feitentabel verdwijnt daarmee niet, maar wordt wel veel eenvoudiger. De vraag 'welke winkels liggen in Amsterdam?' wordt beantwoord in een winkeldimensie van 300 rijen, en wat daarna naar de feitentabel gaat, is alleen nog een lijstje keys. In de 75 miljoen feitenregels hoeft de engine dan geen tekst te vergelijken, maar alleen in de keykolom te kijken welke rijen meedoen, en die vervolgens op te tellen.
Granulariteit
Welke dimensies je wilt kunnen gebruiken, dwingt de granulariteit van de feitentabel af: wil je per winkel kunnen analyseren, dan moet elke rij minstens tot op winkelniveau zijn vastgelegd. Een fijne granulariteit maakt veel analytische diepgang mogelijk en houdt een model flexibel en toekomstbestendig, ook als wensen uit de business veranderen. Een model met een grovere granulariteit kan echter uit minder rijen bestaan, waardoor het dashboard aanmerkelijk sneller kan zijn.
Tot slot
Aan het begin van deze blog wilde de gebruiker een volle parkeerplaats met Formule 1-auto's: snel én veel. Een goed datamodel brengt je daar een heel eind. Kolomopslag zorgt dat de computer alleen leest wat hij nodig heeft. Het stermodel houdt de feitentabel smal en laat filters via kleine dimensies lopen. En VertiPaq rekent alles in het geheugen. Zo kan een dashboard over tientallen miljoenen regels toch binnen een seconde antwoord geven.
Helemaal gratis is het niet. Bij de granulariteit komen snelheid en volume weer tegenover elkaar te staan: elk extra detailniveau betekent meer rijen, en meer rijen betekenen meer rekenwerk. Waar je op die schaal uitkomt, is geen technische keuze die je in je eentje maakt. Het vraagt om hetzelfde als in mijn vorige blog: goed doorvragen wat de gebruiker echt nodig heeft. Moet het per winkel per dag, of is per regio per week genoeg? Het antwoord op die vraag bepaalt hoe de motor eruitziet.
In mijn volgende blog ga ik in op een vraag die ik vaak krijg: gaat AI dit werk overnemen?
Meer weten of heb je een vraag? Neem dan contact met ons op of plan een kennismakingsgesprek in.